
第 11 章 · 数据分析
用 Python 走完数据分析的完整链路:数据采集 → 数据挖掘 → 数据可视化, 认识每一步对应的库(requests / re / json / matplotlib),并动手跑通正则、JSON 和画图。 本章 7 讲(087–093)
🎯 本章目标
- 说清数据分析的一般流程(采集 → 挖掘 → 可视化),以及每一步对应的 Python 库
- 理解数据采集背后的 HTTP 协议:请求方式、请求头、状态码分别是什么
- 讲明白并行执行的原理:为什么下载图片时多线程/多进程更快,什么时候用哪个
- 学会用正则表达式
re处理「有规律但格式乱」的非规范化数据 - 学会用
json在 Python 对象和 JSON 字符串之间互转 - 把网页数据抓下来并存成文本文件
- 用
matplotlib把数据画成折线图、柱状图
本章代码
📌 代码约定:正文代码块都保持可直接运行;节选会明确标注「节选」并指向
code/完整文件。 所有输出都是真实运行结果(本机 Python 3.12.7)。 本章需要联网的「抓真实网页」部分标注为「本节为说明,未实跑」,其余示例均可直接python3跑通。
| 文件 | 内容 |
|---|---|
code/87-overview.py | 用标准库跑一遍「采集 → 处理 → 展示」的最小闭环 |
code/88-http-demo.py | 离线拆解 URL、组装 GET 请求,认识 HTTP 协议 |
code/89-parallel.py | 串行 / 多线程 / 多进程跑同一批任务的耗时对比 |
code/90-regex.py | json 编解码 + 正则表达式 + 课后作业 |
code/91-fetch-and-save.py | 抓网页存文件(未实跑)+ 从本地 HTML 提取数据存文件(实跑) |
code/92-plot.py | 用 matplotlib 画北京/上海一周气温图 → code/plot-demo.png |
第 87 讲 · 理论盘点:数据分析的流程及对应的 Python 库
本节目标
先建立整体地图:知道数据分析是干什么的、分成哪几步、每一步该用哪个库。 本讲以讲解为主,末尾用一个只用标准库的小例子把三步流程走一遍。
知识要点
1. 数据分析对企业的价值
- 用户行为分析可以优化业务、提升用户体验
- 业务数据分析可以提前规避风险、识别机会
- 合理运用数据分析技术,还能提高投入产出比(ROI)
2. 数据分析的一般流程
数据分析遵循三个主要过程:
| 阶段 | 做什么 |
|---|---|
| 数据采集 | 拿到原始数据。可以基于公司积累的数据,也可以基于公开数据,通常两者结合 |
| 数据挖掘 | 数据理解 → 数据准备 → 建立模型 → 数据清洗 → 数据存储 → 模型评估 |
| 数据可视化 | 建立各类图表,按不同维度展示,让人一眼看出规律 |
⚠️ 采集数据时要遵守《中华人民共和国个人信息保护法》——数据不是想抓就能抓。
3. 数据分析用到的 Python 库
| 环节 | 常用库 |
|---|---|
| 数据采集 | requests(发 HTTP 请求抓网页) |
| 数据挖掘 | re、BeautifulSoup、pandas、Scikit-learn |
| 数据可视化 | matplotlib、Seaborn |
4. 一句话总结
数据分析有采集、挖掘、展示三个过程;每个过程都有成熟的 Python 库支撑, 所以用 Python 可以实现数据分析的全套技术栈。
代码实操
下面这段程序只用标准库,把「采集 → 挖掘 → 展示」走了一遍,帮助你先把流程记牢:
python
"""第 87 讲 · 理论盘点:数据分析的流程及对应的 Python 库"""
raw_data = [
    "Beijing,20220620,30",
    "Beijing,20220621,31",
    "Beijing,20220622,29",
    "Beijing,20220623,28",
    "Shanghai,20220620,32",
    "Shanghai,20220621,33",
    "Shanghai,20220622,31",
    "Shanghai,20220623,30",
]

# 2. 数据挖掘(数据准备 + 清洗 + 统计)
records = []
for line in raw_data:
    city, day, temp = line.split(",")      # 清洗:按逗号拆开
    records.append((city, day, int(temp))) # 气温转成整数

by_city = {}
for city, day, temp in records:
    by_city.setdefault(city, []).append(temp)
avg = {city: sum(temps) / len(temps) for city, temps in by_city.items()}

for row in records:
    print("   ", row)

# 3. 数据可视化(先用文本条形图)
for city, value in avg.items():
    bar = "█" * round(value)
print(f" {city:<9}{bar} {value:.1f}")运行命令与真实输出:
bash
$ python3 87-overview.py
清洗后的数据:
    ('Beijing', '20220620', 30)
    ('Beijing', '20220621', 31)
    ('Beijing', '20220622', 29)
    ('Beijing', '20220623', 28)
    ('Shanghai', '20220620', 32)
    ('Shanghai', '20220621', 33)
    ('Shanghai', '20220622', 31)
    ('Shanghai', '20220623', 30)

按城市统计的平均气温:
    Beijing: 29.5 °C
    Shanghai: 31.5 °C

文本条形图(每个 █ 代表 1 °C):
    Beijing  ██████████████████████████████ 29.5
    Shanghai ████████████████████████████████ 31.5

提示:第 92 讲会用 matplotlib 把这些数字画成真正的折线图。💡 这就是数据分析的缩影:原始字符串 → 结构化数据 → 能看懂的图形。 第 92 讲我们会把最后那个文本条形图换成真正的图表。
课后作业
请你根据所在地区的气温、天气,使用 Excel 工具绘制一张天气和气温变化图表。
参考答案思路:用课程里同样的「日期 / 天气 / 气温」三列数据,选中后插入「折线图」, 横轴放日期、纵轴放气温即可。会了 Excel 之后,第 92 讲我们用 Python 复现一遍。
第 88 讲 · 理论盘点:数据采集的方法与 HTTP 协议
本节目标
搞清「抓网页」背后到底发生了什么:Python 发一个 HTTP 请求,服务器返回网页源代码。 认识 URL 的组成、请求的两种方式(GET / POST)、以及状态码。
知识要点
1. 基于 HTTP 协议实现数据采集的原理
用浏览器上网,其实是两步:
你输入网址 ──► 浏览器发出 HTTP 请求 ──► 服务器把网页源代码传回浏览器 ──► 浏览器渲染展示Python 抓网页是一模一样的两步,只是把「浏览器」换成「Python 程序」:
Python 发出 HTTP 请求 ──► 服务器返回网页源代码 ──► Python 直接解析这坨字符串区别在于:浏览器把源代码「画」成页面,Python 则把源代码当字符串拿来提取数据。
2. HTTP 协议速查
- 常见的客户端请求方式:GET(向服务器要数据)、POST(向服务器提交数据)
- 一次请求/返回包含三部分:HTTP 头(header)、HTTP 主体(body)、返回码(status code)
课程里用 requests 抓网页的样子:
python
import requests
r = requests.get('https://www.example.com', auth=('user', 'pass'))
r.status_code          # 200
r.headers['content-type']  # 'application/json; charset=utf8'
r.encoding             # 'utf-8'
r.text                 # '{"authenticated": true, ...'
r.json()               # {'authenticated': True, ...}
r是 response(响应)对象:r.status_code是状态码,r.text是文本内容,r.json()会把 JSON 文本直接解析成 Python 字典。
3. 常见状态码
| 状态码 | 含义 |
|---|---|
| 200 | 请求成功 |
| 301 / 302 | 重定向(地址变了) |
| 403 | 没有权限(常因缺少 User-Agent) |
| 404 | 资源不存在 |
| 500 | 服务器内部错误 |
4. 网页文字 / 图片的提取
- 用
r.text拿到的是带样式的完整源代码,要提取纯文字必须把 HTML 标签、样式剔除 - 网页里的图片放在
<img>标签里;一个页面里多张图片的<img>往往有相似规律, 可以用for循环批量提取
代码实操
为了不联网也能讲清 HTTP,下面这个脚本做两件离线的真事: 拆解 URL 的组成部分;用 requests.Request 在不发网络请求的前提下,把「即将发送的 GET 请求」组装出来看看。
python
"""第 88 讲 · 理论盘点:数据采集的方法与 HTTP 协议"""
from urllib.parse import urlparse, parse_qs, urlencode
from requests import Request

url = "https://www.example.com/resource?plus=0&m=0&d=3&c=12&sort=2&order=desc"
parsed = urlparse(url)
print("scheme(协议)  :", parsed.scheme)
print("netloc(主机名):", parsed.netloc)
print("path(路径)    :", parsed.path)
print("query(查询参数):", parsed.query)

params = parse_qs(parsed.query)
print("只取 sort 参数   :", params["sort"][0])

headers = {"User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                         "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120 Safari/537.36"}
req = Request("GET", url, headers=headers).prepare()   # 只组装,不发送
print("方法(method)   :", req.method)
print("地址(url) :", req.url)运行命令与真实输出:
bash
$ python3 88-http-demo.py
原始 URL: https://www.example.com/resource?plus=0&m=0&d=3&c=12&sort=2&order=desc
scheme(协议)  : https
netloc(主机名): www.example.com
path(路径)    : /resource
query(查询参数): plus=0&m=0&d=3&c=12&sort=2&order=desc

拆解后的查询参数: {'plus': ['0'], 'm': ['0'], 'd': ['3'], 'c': ['12'], 'sort': ['2'], 'order': ['desc']}
只取 sort 参数   : 2

重新拼接的查询字符串: city=beijing&days=7

即将发送的请求:
    方法(method)   : GET
    地址(url)      : https://www.example.com/resource?plus=0&m=0&d=3&c=12&sort=2&order=desc
    请求头(headers):
        User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120 Safari/537.36

说明:真正的 requests.get(...) 会把这个请求发到服务器,服务器返回状态码 + 响应体。
常见状态码:200 成功 / 301 永久重定向 / 404 找不到 / 500 服务器错误。📌 上面
.prepare()之后并没有真的发请求,所以断网也能跑。 看懂了req.method/req.url/req.headers,你就明白一次抓取「发明了什么」。
课后作业
请使用 requests 库采集一周内的天气(气温 + 降水),存入文本文件中。
参考答案思路:
requests.get(天气接口URL, headers=...)拿到r.text, 用第 90 讲的正则或第 91 讲的方法把「日期 / 气温 / 降水」提取成每行一条,写进.txt。 因为要联网,本讲的code/88-http-demo.py只演示到「组装请求」这一步。
第 89 讲 · 理论盘点:任务的并行执行原理
本节目标
理解为什么并行下载比一个接一个快,以及「多线程」和「多进程」该怎么选。 本讲以讲解为主,末尾真跑一组串行 / 多线程 / 多进程的耗时对比。
知识要点
1. 并行下载的原理
并行下载成立有三个前提:
- 服务器上的网页能够支持并行访问
- 按 HTTP 协议规定,每次请求相互独立、互不影响
- 客户端能支持并行展示或存储
2. 多进程并行下载网页中的图片
- 并行程序应当控制并发数量
- 并发太高,服务器或本机可能因资源耗尽而「服务不可用」
- ✅ 推荐用进程池模型(固定并发上限)
- ❌ 不推荐「有多少张图就开多少个并发」
3. 多线程并行下载图片
- 同样推荐线程池模型
- 课程把单进程程序改成多线程后,分别比较三种方式的运行时间
- ★ 结论:多进程和多线程都比单进程快;但多进程和多线程之间没有明显差别
💡 为什么?因为下载图片大部分时间花在等待网络上——这是 I/O 密集型任务, 线程在等待时可以让出 CPU 给别人干活。而当任务主要是**计算(CPU 密集型)**时, 受 Python 的 GIL(全局解释器锁)限制,多线程无法真正并行,这时要用多进程。
4. 用标准库实现并行
python
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

with ThreadPoolExecutor(max_workers=4) as pool:      # 线程池
    pool.map(下载函数, 一大堆网址)

with ProcessPoolExecutor(max_workers=4) as pool:     # 进程池
pool.map(计算函数, 一大堆数据)代码实操
分别用串行 / 多线程 / 多进程跑两类任务,看耗时差别——这正是 PPT 里「比较运行时间」的做法:
python
"""第 89 讲 · 理论盘点:任务的并行执行原理"""
import time
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

def io_task(n):
    time.sleep(0.2)          # 模拟「等网络」,I/O 密集
    return n

def cpu_task(n):
    total = 0
    for i in range(8_000_000):   # 模拟「反复算」,CPU 密集
        total += i * i
    return total

def timeit(label, func, tasks, workers=None):
    start = time.perf_counter()
    if workers is None:
        for t in tasks:
            func(t)
    else:
        with workers as pool:
            list(pool.map(func, tasks))
    print(f"{label:<28}{time.perf_counter() - start:.2f} 秒")

if __name__ == "__main__":
    timeit("  串行(一个接一个)", io_task, list(range(6)))
    timeit("  多线程(4 线程池)", io_task, list(range(6)), ThreadPoolExecutor(max_workers=4))
    timeit("  多进程(4 进程池)", io_task, list(range(6)), ProcessPoolExecutor(max_workers=4))
# CPU 任务同理……运行命令与真实输出(耗时每次略有浮动,量级稳定):
bash
$ python3 89-parallel.py
任务 A(I/O 密集型,6 个任务,每个 sleep 0.2 秒)
  串行(一个接一个)                 1.24 秒
  多线程(4 线程池)                0.41 秒
  多进程(4 进程池)                0.50 秒
  => 结论:I/O 等待时线程能同时等待,多线程明显更快。

任务 B(CPU 密集型,6 个任务,每个反复做大量乘法)
  串行(一个接一个)                 1.43 秒
  多线程(4 线程池)                1.23 秒
  多进程(4 进程池)                0.50 秒
=> 结论:受 GIL 限制,多线程无法加速纯计算;多进程才能真正并行。📌 看结论:I/O 任务用线程、CPU 任务用进程。这和 PPT 的「多进程多线程在下载场景没有明显差别」 并不矛盾——下载是 I/O 任务,两者都快;但换成纯计算,差别立刻就出来了。
课后作业
把「下载」和「文件保存」两个函数分别放进两个进程池,能否提高下载效率?请用代码实现并观察执行时间。
参考答案:一般不会提高。下载是 I/O 任务,瓶颈在等网络,拆成两个池并不能减少等待时间, 反而多了一层进程间通信开销;而且《第 91 讲》提醒过「并发写入会导致文件数据丢失」, 两个池同时写盘还需加锁。**一个线程池 + 池内完成「下载→保存」**通常最简单也最快。
第 90 讲 · 理论盘点:非规范化数据处理的基础与正则表达式
本节目标
掌握处理「格式乱」的数据的两大利器:json 负责规范格式互转,re 负责从乱字符串里 按规律拆分、替换、查找。本讲的重点在真跑。
知识要点
1. 非规范化数据分类
| 类型 | 例子 |
|---|---|
| 完全无格式数据 | 一整段纯文本 |
| 有特定规律的数据 | JSON、以特定符号分隔的数据 |
| 规范数据里的脏数据 | 空数据、多余空格、特殊字符、乱码 |
2. 类型转换库
- 常见的结构化文本格式有 json 和 xml 两种
json.dumps():把 Python 对象编码成 JSON 字符串json.loads():把 JSON 字符串解码成 Python 对象- xml 格式可用
xml.etree包解析
3. 正则表达式的工作过程
原始字符串 AABBCC ──正则表达式 BB──► 目标字符串 AACC更复杂的情况(B+ 表示「一个或多个 B」):
原始字符串 AAB...BCC ──正则表达式 B+──► 目标字符串 AACC4. 常用元字符
| 元字符 | 含义 |
|---|---|
. | 任意 1 个字符 |
* | 前一个字符出现 0 次或多次 |
? | 前一个字符出现 0 次或 1 次 |
+ | 前一个字符出现 1 次或多次 |
() | 分组(把匹配结果分组取出) |
5. 用 re 处理非规范数据
Python 用 re 库做正则匹配,并在匹配后实现数据的查找与删除:
python
import re
re.split(r'\W+', 'Words, words, words.', 1) # ['Words', 'words, words.']更复杂的替换用:
python
re.sub(pattern, repl, string, count=0, flags=0)代码实操
bash
$ python3 90-regex.py
一、json 处理
----------------------------------------------
dict1                : {'a': 123, 'b': 456}
json.dumps(dict1)    : {"a": 123, "b": 456}   (类型: str )
json.loads(json_string): {'a': 123, 'b': 456}   (类型: dict )
取回 a 的值          : 123

解析接口返回:status = 200
              city   = Beijing
              temp   = 30

中文转 JSON(默认)  : {"city": "\u5317\u4eac"}
中文转 JSON(可读)  : {"city": "北京"}

二、正则表达式 re
----------------------------------------------
原始字符串           : Words, words, words12312321321.
re.split(r'\W+', strings, 1) : ['Words', 'words, words12312321321.']

替换前               : '  北京  ,   20220620 , 30  '
re.sub(r'\s+', '', messy) : '北京,20220620,30'

从 HTML 里找图片地址 : ['a.jpg', 'b.png', 'c.gif']

匹配日期             : 2022-06-20 (整段)
                     年 = 2022 月 = 06 日 = 20

常用元字符演示:
  .    任意 1 个字符        re.findall(r'a.c', 'abc adc aac') -> ['abc', 'adc', 'aac']
  *    前一个字符 0 次或多次 re.findall(r'ab*', 'a ab abb')     -> ['a', 'ab', 'abb']
  +    前一个字符 1 次或多次 re.findall(r'ab+', 'a ab abb')     -> ['ab', 'abb']
  ?    前一个字符 0 次或 1 次 re.findall(r'ab?', 'a ab abb')    -> ['a', 'ab', 'ab']

re.compile(r'\d+').findall('abc 12 def 345') -> ['12', '345']

三、课后作业:把乱格式字符串还原成字典
----------------------------------------------
原始字符串           : ' "{" hello ":" world "}" '
整理为合法 JSON      : {"hello":"world"}
最终得到的字典       : {'hello': 'world'}
按 key 取值 : world关键代码(完整版见 code/90-regex.py):
python
import re, json

# json 互转
json.dumps({"a": 123, "b": 456})      # Python 对象 -> JSON 字符串
json.loads('{"a": 123, "b": 456}')    # JSON 字符串 -> Python 对象
json.dumps({"city": "北京"}, ensure_ascii=False)   # 中文保持可读

# 正则四种常用操作
re.split(r"\W+", "Words, words, words12312321321.", 1)   # 拆分
re.sub(r"\s+", "", "  北京  ,   20220620 , 30  ")         # 替换(去掉空白)
re.findall(r'src="([^"]+)"', html)                        # 查找所有
re.search(r"(\d{4})-(\d{2})-(\d{2})", "2022-06-20 北京 30度") # 分组匹配💡
\W(大写 W)表示「非单词字符」(逗号、空格、句号等);\s表示「空白字符」;\d表示「数字」。加号+表示「前一个字符出现 1 次或多次」。
课后作业
已知原始数据 string = ' "{" hello ":" world "}" ',请用正则和相关库把它转成 Python 字典并输出。
参考答案(正文已跑通,见上面「三、课后作业」的输出): 先去空白、剥掉外层双引号,再用
re.sub把键值两侧多余的空格去掉,得到合法 JSON,最后json.loads:pythonraw = ' "{" hello ":" world "}" ' inner = raw.strip()[1:-1] # '{" hello ":" world "}"' inner = re.sub(r'"\s*', '"', inner) # '{"hello":"world"}' inner = re.sub(r'\s*"', '"', inner) print(json.loads(inner)) # {'hello': 'world'}
第 91 讲 · 如何获取网页上的数据并存储到文件?
本节目标
把前几讲的采集能力落地:抓网页 → 提取数据 → 存成文件。同时分清文本文件和数据库两种存储方式。
⚠️ 本节分两部分:从真实网页抓取需要联网,标注「本节为说明,未实跑」; 从本地 HTML 文本提取数据不联网,逻辑完全一样,这部分是实跑的。
知识要点
1. 用文本文件保存数据
- Python 一般通过 HTTP 协议的 GET 方式抓取网页数据
- 抓到的原始数据往往要反复用于多次分析,所以需要存到磁盘
- 文本文件、数据库都可以存放抓取的数据:
| 存储方式 | 特点 |
|---|---|
| 文本文件 | 存储简单、稳定,但不易搜索 |
| 数据库 | 接口丰富、方便查找,但操作比文本文件复杂 |
2. 文本文件存储的两种常见逻辑
- 用
for循环遍历网页上的元素,用「元素 + 时间」作为每个数据项的文件名 - 用追加模式(
open(path, "a"))把网站数据逐条写入同一个文件
⚠️ 注意:并发写入会导致文件数据丢失——多个线程/进程同时写一个文件时,内容会互相覆盖。
3. 用数据库保存数据
以 MySQL 为例,需要完成安装、启动服务、初始化服务三步。 用 MySQLdb 连接数据库的参数:
python
conn = MySQLdb.connect(host="127.0.0.1", port=3306, user="root", passwd="root", db="test")| 参数 | 含义 |
|---|---|
host | MySQL 服务器所在 IP |
port | 服务器端口(默认 3306) |
user | 用户名 |
passwd | 密码 |
db | 要使用的数据库 |
以采集到的城市气温为例,表结构可以这样设计:
| 城市 | 日期 | 气温(摄氏度) |
|---|---|---|
| Beijing | 20220620 | 30 |
| Shanghai | 20220620 | 32 |
| Beijing | 20220621 | 31 |
设计数据库的三个小问题:
- 为了找到唯一记录,要给表设计唯一的 ID
- 为了并发写入,要把数据库查询操作封装成函数或类
- 写入后必须
commit()提交才生效,并发写入时这一步最容易忘
代码实操
A. 抓真实网页(本节为说明,未实跑)
下面是从真实网页抓取并保存的完整函数。它需要联网、且目标网站可能改版,所以本节未在本机执行:
python
import requests

def fetch_html(url, save_as=None):
    """用 HTTP 的 GET 方式抓取一个网页,返回网页源代码文本。"""
    headers = {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                      "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120 Safari/537.36"
    }
    r = requests.get(url, headers=headers, timeout=10)
    r.encoding = "utf-8"        # 中文网页一般用 utf-8,避免乱码
    if save_as:                 # 顺带把原始网页存一份,方便以后反复分析
        with open(save_as, "w", encoding="utf-8") as f:
            f.write(r.text)
    return r.text

# 【本节为说明,未实跑】正式跑时取消注释即可:
# html = fetch_html("https://www.weather.com.cn/weather/101010100.shtml",
# save_as="beijing_weather.html")B. 从本地 HTML 提取数据并存文件(实跑)
把网页源代码换成本地的一段 HTML 字符串,用正则提取表格文字和图片地址,再存成文本文件—— 提取逻辑与抓真网页完全一样:
bash
$ python3 91-fetch-and-save.py
从 HTML 中提取到的表格数据:
    2022-06-20  晴  最高 30°C
    2022-06-21  多云  最高 31°C
    2022-06-22  阴  最高 29°C
    2022-06-23  小雨  最高 28°C
    2022-06-24  晴  最高 27°C
    2022-06-25  晴  最高 26°C
    2022-06-26  多云  最高 30°C

从 HTML 中提取到的图片地址: ['sun.png', 'cloud.png']

数据已保存到:/Users/pengshicong/Desktop/zero-basics-python-cn/11-data-analysis/code/weather.txt
文件内容:
日期,天气,最高气温
2022-06-20,晴,30
2022-06-21,多云,31
2022-06-22,阴,29
2022-06-23,小雨,28
2022-06-24,晴,27
2022-06-25,晴,26
2022-06-26,多云,30

提示:把 html 换成 fetch_html(...) 抓回来的真实网页文本,这套提取逻辑同样适用。关键代码(完整版见 code/91-fetch-and-save.py):
python
import os, re

# 提取所有 <td>...</td>,每 3 个一组(日期、天气、气温)
cells = re.findall(r"<td>(.*?)</td>", html)
rows = [cells[i:i + 3] for i in range(0, len(cells), 3)]

# 提取所有 <img> 的图片地址
imgs = re.findall(r'<img src="([^"]+)"', html)

# 存成文本文件:一行一条记录,用逗号分隔
out_path = os.path.join(os.path.dirname(os.path.abspath(__file__)), "weather.txt")
with open(out_path, "w", encoding="utf-8") as f:
    f.write("日期,天气,最高气温\n")
    for day, weather, temp in rows:
f.write(f"{day},{weather},{temp}\n")💡
.*?是非贪婪匹配:尽量少地匹配字符,所以(.*?)正好取到一对<td></td>之间的内容。 一个页面里的多张图片,就是靠re.findall一次性全找出来的——这就是 PPT 说的「用 for 循环处理」。
课后作业
把课程演示的表结构(ID, 城市, 日期, 温度)改为只保留「城市 + {日期:温度}」的 JSON 形式。
- 原格式:
1,北京,20220620,30/2,北京,20220621,28 - 新格式:
1,北京,{"20220620":30, "20220621":28}
参考答案思路:把同城的记录聚合到字典里——
pythonimport json data = {"北京": {}, "上海": {}} rows = [(1, "北京", "20220620", 30), (2, "北京", "20220621", 28)] for _id, city, day, temp in rows: data.setdefault(city, {})[day] = temp for i, (city, temps) in enumerate(data.items(), 1): print(f'{i},{city},{json.dumps(temps, ensure_ascii=False)}') # 2 个字段:ID、城市 + 一个 {日期:温度} 的 JSON 值
第 92 讲 · 小试牛刀:如何将数据进行图形化展示?
本节目标
用 matplotlib 把北京、上海一周气温画成折线图和柱状图,并保存成图片文件。 本讲的核心是真跑出图:正文里的 plot-demo.png 就是本节脚本生成的。
知识要点
1. 图形化展示的意义
一组数据:25 28 30 31 31 29 26 24——你能一眼看出规律吗? 再来两行:如果不看第一组,你还找得到规律吗?
- 通过图形化更容易找到规律
- 图形化更加直观
2. 图形化库 Matplotlib
- Matplotlib 是 Python 里最常用的 2D 绘图库
- 它主要由三部分组成:画布(figure)、坐标系(axes)、坐标轴(axis)
- 一块画布上可以有一个或多个坐标系;每个坐标系上有坐标轴
图(figure)
 └─ 坐标系(axes)
└─ 坐标轴(axis:x 轴、y 轴)3. 关于展示
- Notebook 不会像 Python 终端那样自动展示图表
- 如果用 Notebook 跑 Matplotlib,绘图时需要加
figure.show()之类的调用 - 我们这里用
fig.savefig(...)把图存成 png 文件,无图形界面也能跑(也不依赖 Notebook)
代码实操
python
"""第 92 讲 · 小试牛刀:如何将数据进行图形化展示?"""
import os
import matplotlib
matplotlib.use("Agg")                      # 不弹窗口,直接输出图片文件
import matplotlib.pyplot as plt

# 中文字体,避免标题变方块
plt.rcParams["font.sans-serif"] = ["PingFang SC", "Heiti SC", "Arial Unicode MS",
                                   "Microsoft YaHei", "SimHei"]
plt.rcParams["axes.unicode_minus"] = False

days = ["6-20", "6-21", "6-22", "6-23", "6-24", "6-25", "6-26"]
beijing = [30, 31, 29, 28, 27, 26, 30]
shanghai = [32, 33, 31, 30, 29, 28, 31]

fig, axs = plt.subplots(2, 1, figsize=(8, 8))     # 一块画布 + 上下 2 个坐标系

# 上:折线图,看趋势
axs[0].plot(days, beijing, marker="o", label="北京")
axs[0].plot(days, shanghai, marker="s", label="上海")
axs[0].set_title("北京、上海一周气温变化")
axs[0].grid(True)
axs[0].legend()

# 下:柱状图,做对比
axs[1].bar(days, beijing, label="北京")
axs[1].bar(days, shanghai, label="上海")

fig.tight_layout()
fig.savefig(os.path.join(os.path.dirname(os.path.abspath(__file__)), "plot-demo.png"), dpi=120)运行命令与真实输出:
bash
$ python3 92-plot.py
北京气温: [30, 31, 29, 28, 27, 26, 30]
上海气温: [32, 33, 31, 30, 29, 28, 31]

图表已保存到:/Users/pengshicong/Desktop/zero-basics-python-cn/11-data-analysis/code/plot-demo.png
文件是否存在: True生成的图如下(文件:code/plot-demo.png,65 KB):
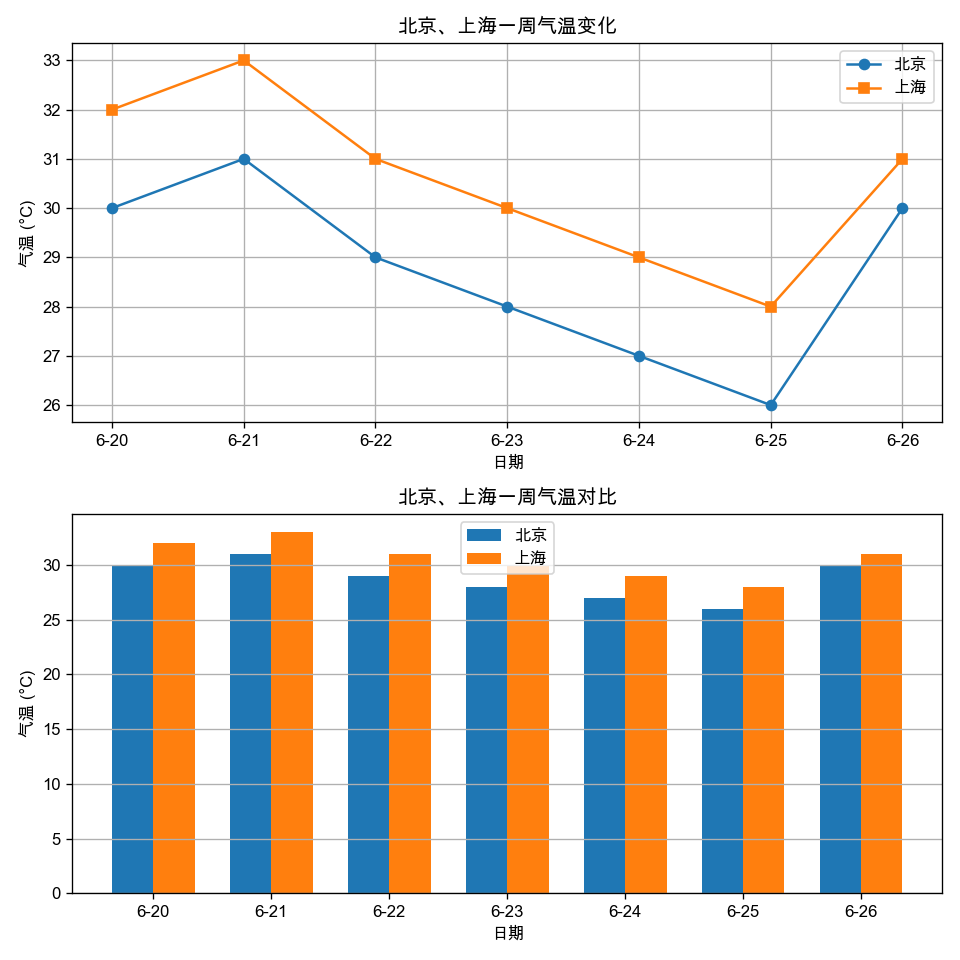
✅ 图上能一眼看出:上海整体比北京高 1–3 °C,两城走势高度一致(从 6-20 升到 6-21 后一路下降到 6-25,再回升)。
💡 先把数据在脑中「画」出来,再看图——这就是第 87 讲说的「图形化更容易发现规律」。
课后作业
请你编写程序,利用 Matplotlib 展示北京、上海两个城市一周内的气温变化曲线。
参考答案:就是本节的
code/92-plot.py——用plot()画两条折线,加legend()区分城市、xlabel/ylabel标注坐标轴、savefig()保存成图片。
第 93 讲 · 再回首:“数据分析”单元小结
本章我们完整走了一遍数据分析的三步链路——采集、挖掘、展示,并用了四个库:requests、re、json、matplotlib。
速查表
| 主题 | 关键点 |
|---|---|
| 数据分析流程 | 数据采集 → 数据挖掘 → 数据可视化 |
| 各阶段库 | 采集 requests;挖掘 re/BeautifulSoup/pandas/sklearn;可视化 matplotlib/Seaborn |
| HTTP 协议 | GET 要数据 / POST 提交数据;看 status_code、headers、text、json() |
| 并行下载 | 用池控制并发;I/O 用线程、CPU 用进程;并发写同一文件会丢数据 |
| JSON | json.dumps() 编码、json.loads() 解码、ensure_ascii=False 保中文 |
| 正则 | re.split 拆、re.sub 替、re.findall 找、re.search 分组;元字符 . * ? + () |
| 存储 | 文本文件简单稳定但难搜索;数据库接口丰富、需 commit() |
| 画图 | matplotlib:画布 figure / 坐标系 axes / 坐标轴 axis;savefig() 存图 |
三句话
- 数据分析就是采集 → 挖掘 → 展示三步,每步都有现成的 Python 库,不用重复造轮子。
- 数据「乱」不要慌:有规律的用
re拆,规范的(JSON/XML)用同名库解析。 - 抓来的数据要存下来(文件或数据库);存下来之后再画成图,规律才会自己「跳出来」。
动手练习
- 跑通
code/90-regex.py,把课后作业里的' "{" hello ":" world "}" '换成' "{" a ": " 1 "}" '再解析一次。 - 跑通
code/91-fetch-and-save.py,把weather.txt的表头改成「日期,天气,最高气温(°C)」。 - 跑通
code/92-plot.py,把图改成「北京、上海、广州」三个城市。 - (进阶)给
code/89-parallel.py加一个「5 个站点 × 各下载 3 张图」的模拟任务,比较单线程与线程池耗时。
下一章预告
第 12 章进入办公自动化:用 Python 批量处理 Excel、Word 等办公文件, 把重复的表格 / 文档工作交给程序,学会用 openpyxl、python-docx 等库替代手工劳动。